红外图像能突出热目标,可见光图像提供纹理和颜色。把两者融合,是希望在一张图里保留互补信息。但当可见光图像有雾、雨、噪声,或者本身就很暗、很模糊时,融合也可能把退化一起带入结果。
AIR-Fusion 研究的是:如何在同一次生成过程中,完成图像恢复与红外–可见光融合,并让文本指令决定恢复的方向。
这篇文章围绕三个设计选择展开:保留预训练扩散模型的恢复能力,通过 CMBA 接入红外条件,以及利用 TCR 在采样过程中约束源图像结构。
为什么保留预训练的恢复主干
图像恢复希望去掉退化,图像融合希望保留不同传感器的互补信息。这两个目标有关联,但并不相同。
一个恢复效果很好的生成模型,不一定知道应该如何使用红外输入。另一方面,从有限融合数据上训练出来的模型,也不一定能处理训练之外的复杂天气和退化。
AIR-Fusion 使用 AutoDIR 的潜空间扩散主干,并在训练中冻结主干参数。需要学习的是接入新条件、校正融合结果的模块。这样,适配过程可以利用已有的恢复先验,而不必在有限的融合数据上重新学习整套恢复能力。
冻结主干之后,接下来要解决的是怎样把红外信息送进去,以及怎样保住源图像的细节。
CMBA:让红外信息参与生成
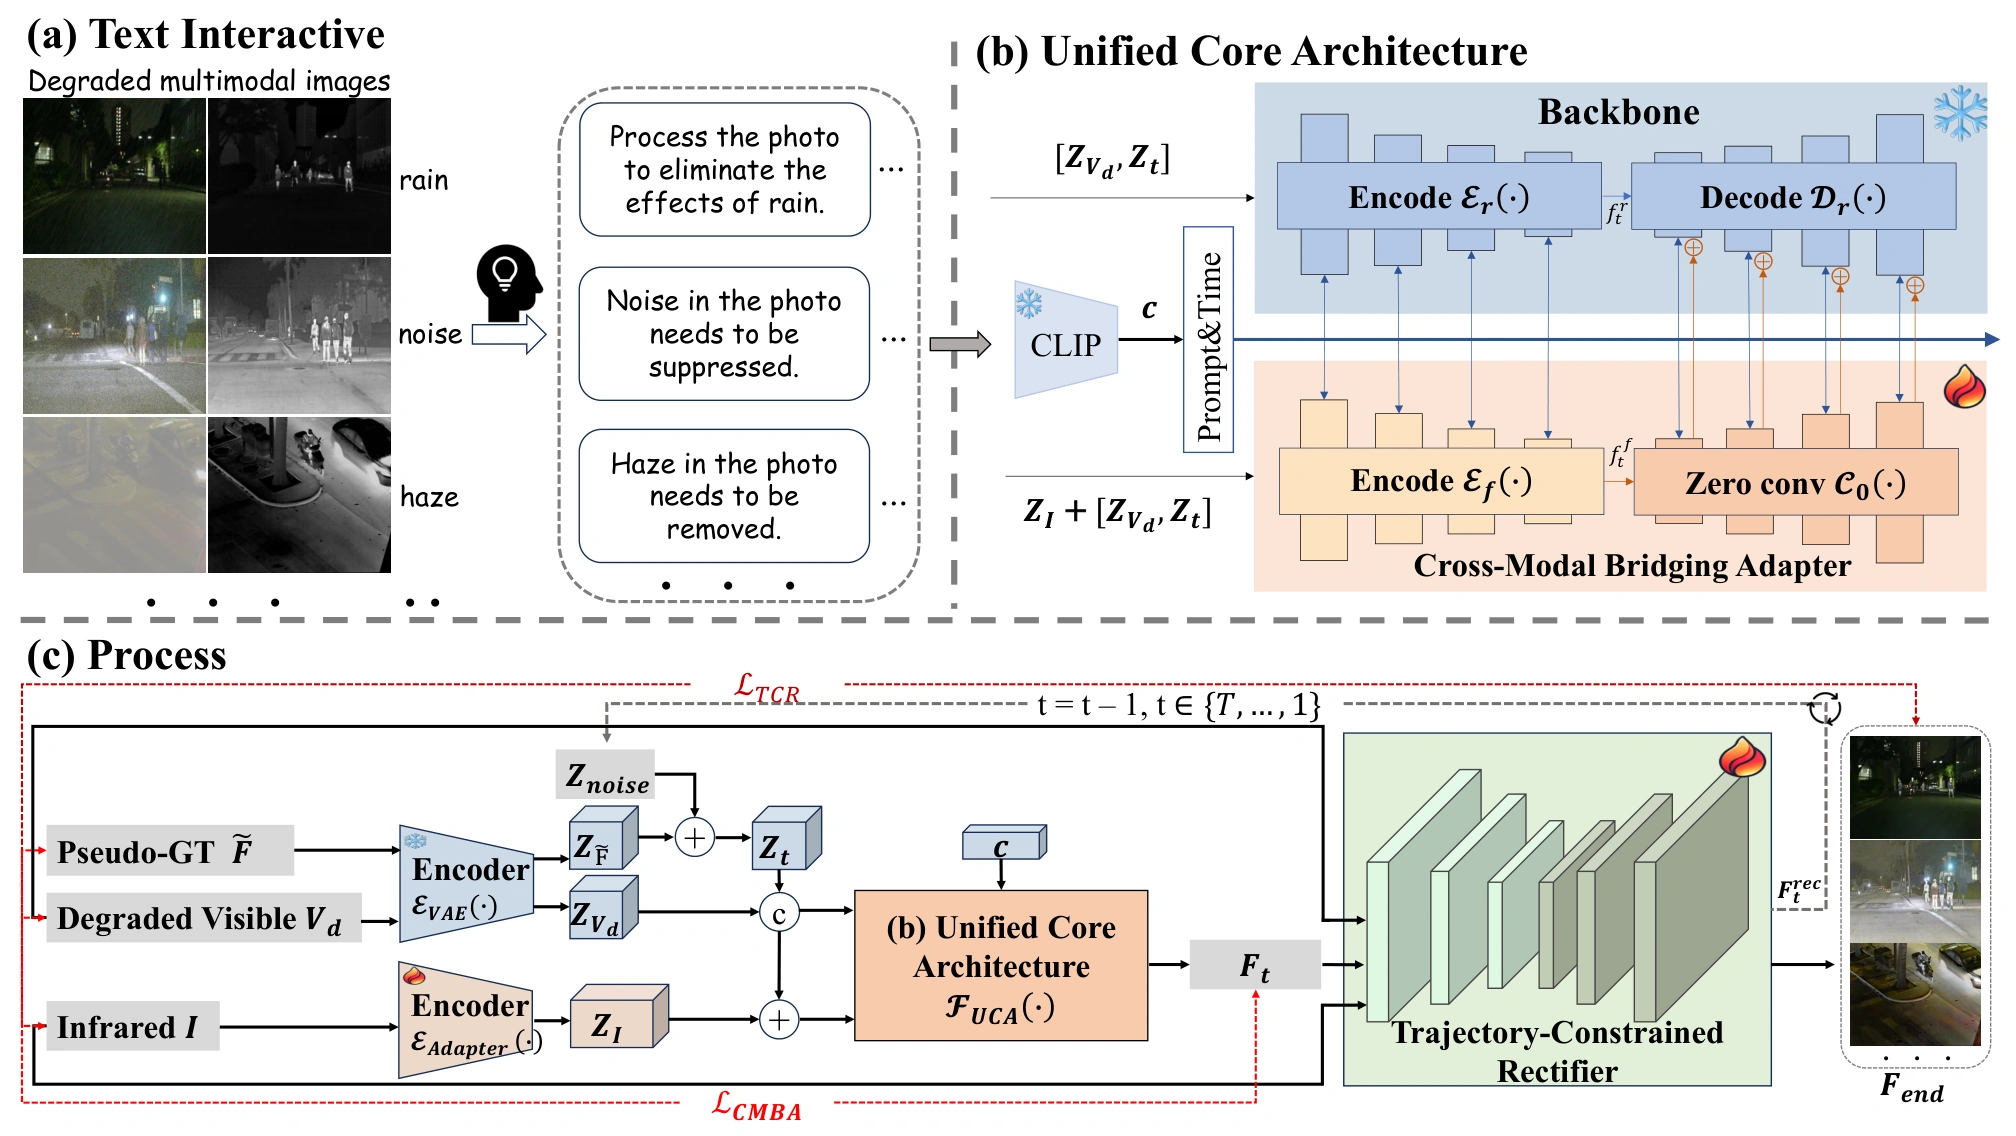
CMBA 的全称是 Cross-Modal Bridging Adapter,即跨模态桥接适配器。可以先把它理解成一个接入红外条件的可训练分支。
主干处理当前带噪潜变量和退化可见光的潜变量;CMBA 分支进一步接入红外编码,在文本指令引导下提取融合相关特征。这些特征经过零初始化卷积,注入冻结主干的多尺度解码特征。
因此,红外信息会参与去噪过程,影响图像如何逐步生成。文本则提供恢复方向,例如去雾或去噪。
这里有一个容易混淆的细节:框架图中的 Pseudo-GT 用于训练。论文利用已有算法生成的高质量融合图像构建代理先验,并对其潜变量加噪,训练噪声预测。推理从高斯噪声开始,不需要额外提供一张理想融合图作为输入。
训练的监督也不只有噪声预测损失。论文还结合了结构相似性、强度、梯度和颜色相关的融合损失,使模型学习的目标更贴近融合任务。
TCR:在采样中保留源图像结构
生成结果看起来清楚,并不等于源图像中的结构都被保留了。对融合任务来说,热目标、物体边缘和细节是否忠实于输入,同样重要。
潜空间扩散模型的 VAE 压缩可能损失高频信息,迭代采样也可能使结果偏离源图像结构。为此,我们引入了 TCR,也就是 Trajectory-Constrained Rectifier,轨迹约束校正器。
在一个采样步骤里,模型先估计干净潜变量,把它解码为当前的融合预测。TCR 同时参考这个预测、退化可见光和红外图像,对结果进行校正。校正后的图像重新编码到潜空间,参与下一步采样。
TCR 的校正结果会进入下一步采样,因此它会影响后续生成过程。
表 2 的消融提供了相应证据:与移除 TCR 的版本相比,完整模型的 VIF 从 0.87 升到 1.04,QAB/F 从 0.57 升到 0.76,PSNR 从 29.01 升到 29.99。不过,去掉颜色损失的版本具有更高的 PSNR,所以不能仅凭单个指标判断最终融合质量。
一套参数,五类退化
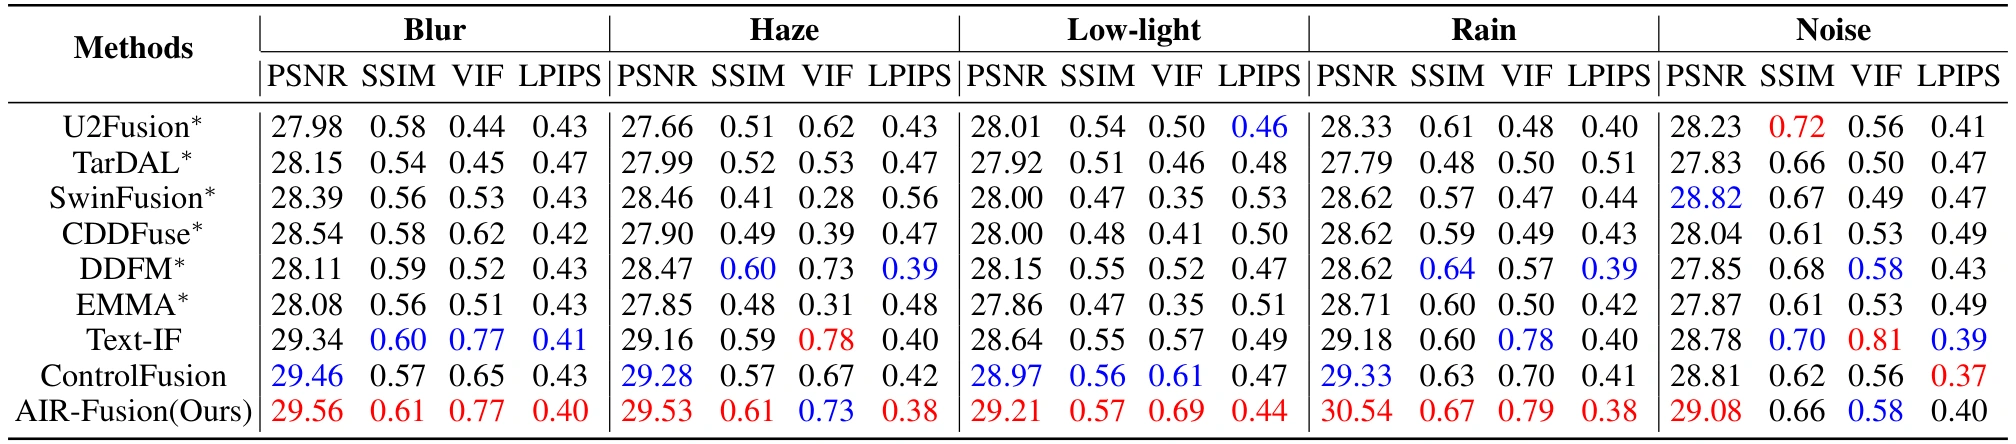
模型只在 LLVIP 上训练,定量测试覆盖 LLVIP,以及未参与训练的 MSRS 和 RoadScene。模糊、雾、低照度、雨和噪声使用同一套模型参数,不需要针对每种退化重新训练。
下面摘录论文表 1 的 PSNR,保留全部对比方法。数值越高越好,单位为 dB。
| 方法 | 模糊 / LLVIP | 雾 / LLVIP | 低照度 / LLVIP | 雨 / MSRS | 噪声 / RoadScene |
|---|---|---|---|---|---|
| U2Fusion* | 27.98 | 27.66 | 28.01 | 28.33 | 28.23 |
| TarDAL* | 28.15 | 27.99 | 27.92 | 27.79 | 27.83 |
| SwinFusion* | 28.39 | 28.46 | 28.00 | 28.62 | 28.82 |
| CDDFuse* | 28.54 | 27.90 | 28.00 | 28.62 | 28.04 |
| DDFM* | 28.11 | 28.47 | 28.15 | 28.62 | 27.85 |
| EMMA* | 28.08 | 27.85 | 27.86 | 28.71 | 27.87 |
| Text-IF | 29.34 | 29.16 | 28.64 | 29.18 | 28.78 |
| ControlFusion | 29.46 | 29.28 | 28.97 | 29.33 | 28.81 |
| AIR-Fusion | 29.56 | 29.53 | 29.21 | 30.54 | 29.08 |
带 * 的方法先用 AutoDIR 恢复退化可见光,再进行融合。交互式方法使用与退化相匹配的提示词。数值均摘自正式论文表 1。
AIR-Fusion 在这五个设置中都取得了最高的 PSNR。不同指标之间仍有取舍:雾场景的 VIF 是 Text-IF 更高;噪声场景的 SSIM、VIF 和 LPIPS 也有其他方法更优。完整表格能更清楚地呈现这些取舍。
文本指令如何改变恢复结果
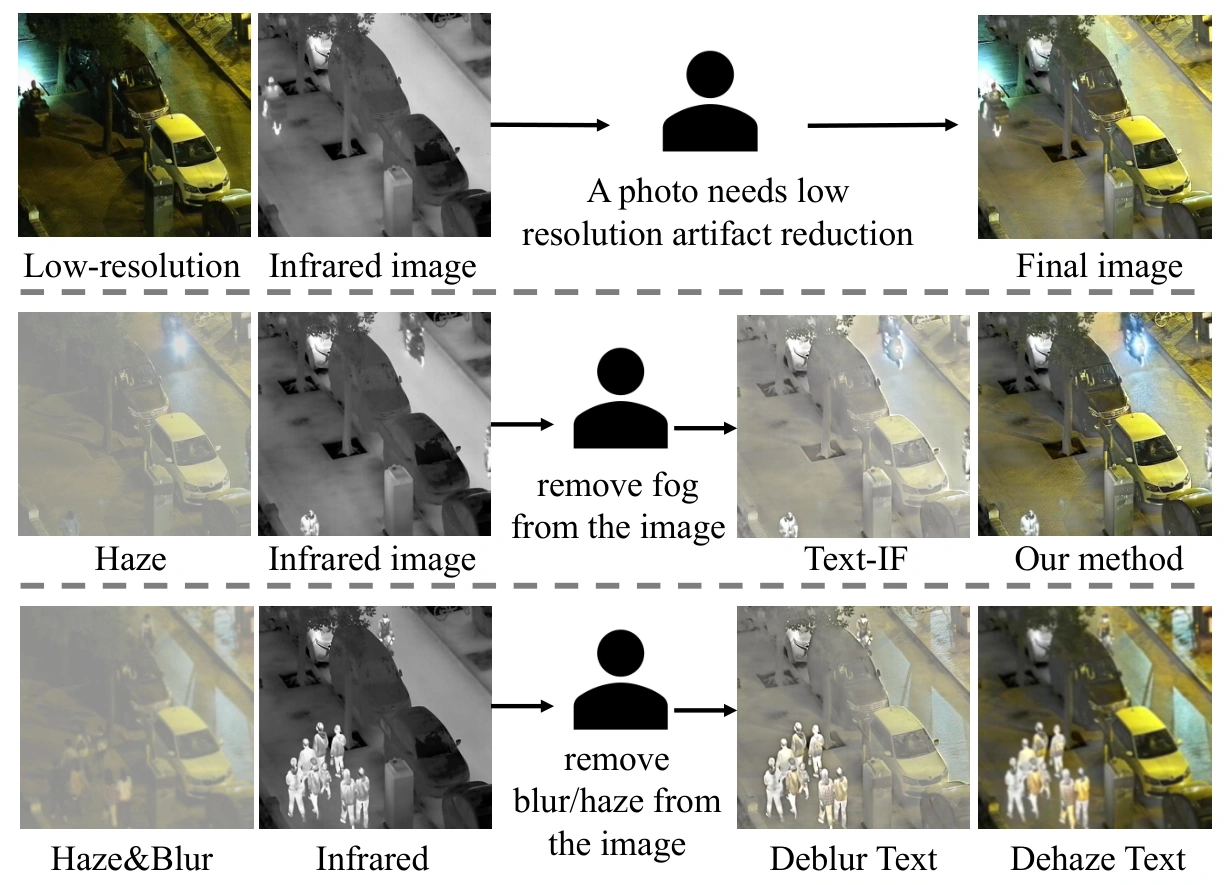
当输入同时有雾和模糊时,“把图像变清楚”其实可以指不同的事情。
论文图 6 展示了一个例子:给出去雾指令,模型主要减轻雾,而模糊特征大体保留;给出去模糊指令,模型主要恢复局部清晰度,而不会同等程度地去掉雾。
局限
这项工作的主要评测对象是可见光侧退化。红外图像也受损、两种模态同时退化、图像配准不准时会怎样,都还需要进一步研究。
效率也是实际问题。论文报告,在 RTX A6000 上使用 100 步去噪,推理耗时为 11.397 秒,可训练参数为 0.361B。这一速度距离实时应用仍有差距。冻结主干减少了需要更新的参数,但扩散采样的计算成本仍然存在。
论文、原始框架图和实验结果已公开。代码与模型权重暂未公开。
论文与联系
Bing Cao, Qiang Zhang†, Xingxin Xu, Pengfei Zhu. Interactive All-in-One Image Restoration and Fusion. IJCAI 2026, pp. 935–943.
† First student author(学生一作);作者顺序与正式论文一致。
本文是作者对已发表研究的中文解读。图表与数值均来自论文,技术细节以正式出版版本为准。